llms.txt: Was es ist und ob KI Ihre Website sieht
llms.txt ist eine Textdatei im Stammverzeichnis einer Domain, die KI-Modellen eine Zusammenfassung der Website und eine Liste ihrer wichtigsten Seiten liefert. Die Idee ist einfach: Statt das Modell über die gesamte Website wandern zu lassen, geben Sie ihm ein fertiges Inhaltsverzeichnis in die Hand.
Bevor Sie die Datei anlegen, sollten Sie allerdings die Antwort auf eine Frage kennen, die die meisten Anleitungen zu diesem Thema geflissentlich umgehen.
Lesen KI-Modelle die llms.txt überhaupt?
Nach heutigem Stand gibt es dafür keinen Beleg – und es gibt durchaus Anzeichen für das Gegenteil.
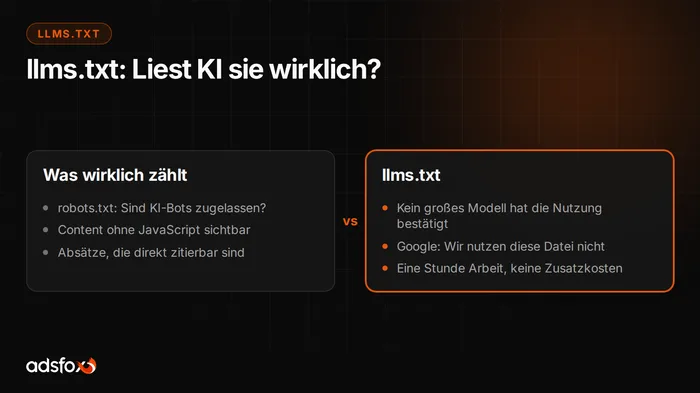
John Mueller von Google hat unmissverständlich erklärt, dass kein KI-System diese Datei nutzt und dass man dies in den Server-Logs erkennt, weil die Crawler die llms.txt nicht einmal abrufen (Search Engine Roundtable). Er verglich sie mit dem Meta-Keywords-Tag – einer Lösung, die seit Jahren wirkungslos ist.
Bei OpenAI stellt sich die Lage ähnlich dar. Die Dokumentation der Crawler (GPTBot, OAI-SearchBot, ChatGPT-User) beschreibt die Zugriffssteuerung ausschließlich über die robots.txt und erwähnt llms.txt kein einziges Mal. Keines der großen Unternehmen – weder OpenAI noch Google noch Anthropic – hat öffentlich bestätigt, die Datei im laufenden Betrieb tatsächlich zu berücksichtigen.
Der Standard selbst ist lediglich ein Vorschlag, veröffentlicht unter llmstxt.org, keine Branchenvereinbarung wie die robots.txt. Dahinter steht weder eine Durchsetzungsinstanz noch die erklärte Absicht eines einzigen Anbieters, ihn zu übernehmen.
Warum die Datei dann überhaupt anlegen?
Aus drei Gründen – und keiner davon hat mit Zauberei zu tun.
Sie kostet eine Stunde und sonst nichts. Kein Pflegeaufwand, kein Risiko, keine Möglichkeit, sich damit zu schaden.
Sie zwingt zur Ordnung. Wer eine gute llms.txt schreiben möchte, muss jede Leistung in einem Satz beschreiben und entscheiden, welche Seiten tatsächlich zählen. Diese Übung deckt meist ein unaufgeräumtes Angebot auf und liefert nebenbei fertige Beschreibungen für andere Zwecke, etwa für Branchenverzeichnisse und das Google-Unternehmensprofil.
Sie ist eine günstige Wette. Setzt sich der Standard durch, sind Sie ohne Hektik vorbereitet. Setzt er sich nicht durch, haben Sie eine Stunde investiert – mehr nicht.
Was Sie hingegen unterlassen sollten: die Datei als Maßnahme zu betrachten, deren Wirkung Sie messen können, oder dafür zu bezahlen wie für eine Dienstleistung. Wer Ihnen llms.txt als Schlüssel zur KI-Sichtbarkeit verkauft, verkauft Ihnen Hoffnung – nicht mehr.
Was wirklich entscheidet, ob KI Ihre Website sieht
Drei Faktoren, in der Reihenfolge ihrer Bedeutung.
1. Ob KI-Crawler zugelassen sind
Das ist eine Ja-oder-Nein-Bedingung und die häufigste Ursache für Unsichtbarkeit. KI-Bots sind eigenständige Agenten, getrennt vom Googlebot, und werden sehr häufig blockiert – nicht durch eine bewusste Entscheidung, sondern durch Standardeinstellungen des Hostings, des CDN oder eines Sicherheits-Plugins.
Um diese Agenten geht es konkret:
- GPTBot, OAI-SearchBot, ChatGPT-User (OpenAI)
- PerplexityBot (Perplexity)
- ClaudeBot, Claude-Web, anthropic-ai (Anthropic)
- Google-Extended (Google, getrennt vom Googlebot)
- Applebot-Extended (Apple)
- CCBot (Common Crawl, eine Quelle für Trainingsdaten vieler Modelle)
Enthält die robots.txt keine Angaben zu diesen Agenten, gilt die allgemeine Regel. Besteht jedoch eine Sperre, verschwinden Sie vollständig aus diesem Kanal – unabhängig von der Qualität Ihrer Inhalte.
Es lohnt sich daher, dies ausdrücklich festzulegen, statt sich auf das Standardverhalten zu verlassen:
User-agent: GPTBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /
Ein Hinweis zur Rechtslage im deutschsprachigen Raum: Wer seine Inhalte nicht für das Training von Modellen freigeben möchte, aber dennoch in KI-Antworten auftauchen will, kann differenzieren. GPTBot sammelt Trainingsdaten, OAI-SearchBot hingegen liefert Quellen für die Suche innerhalb von ChatGPT. Die Sperre des einen bei gleichzeitiger Freigabe des anderen ist rechtlich zulässig und für manche Unternehmen die passende Lösung.
2. Ob die Inhalte ohne JavaScript existieren
Manche KI-Crawler führen kein JavaScript aus oder tun dies nur selektiv. Lädt Ihre Website Inhalte erst im Browser nach, sieht ein Bot unter Umständen lediglich einen leeren Rahmen. Serverseitig gerenderte oder statisch erzeugte Seiten sind von diesem Problem nicht betroffen.
Schnelltest: Schalten Sie JavaScript im Browser aus und öffnen Sie Ihre Leistungsseite. Das entspricht ungefähr dem, was ein einfacherer Bot sieht.
3. Ob sich die Inhalte zitieren lassen
Selbst mit Zugang und sauberem HTML muss das Modell etwas vorfinden, das es übernehmen kann. Es wählt Passagen, die eine Frage vollständig beantworten, ohne Bearbeitung. Ein Absatz, der mit einer Aufwärmphase beginnt und den Kern im dritten Satz versteckt, verliert gegen einen Absatz, der sofort antwortet.
Ausführlicher behandeln wir das in unserem Beitrag darüber, was Generative Engine Optimization ist, und im Leitfaden zu ChatGPT SEO.
So prüfen Sie, ob KI Ihre Website sieht: vier Schritte
Schritt 1: Serverlogs
Die zuverlässigste Quelle. Durchsuchen Sie die Logs der letzten dreißig Tage nach den oben genannten Agentennamen. Auf einem Server mit Shell-Zugang genügt ein Befehl:
grep -icE "GPTBot|OAI-SearchBot|ChatGPT-User|PerplexityBot|ClaudeBot|CCBot" access.logIst das Ergebnis null, hat Sie in diesem Zeitraum kein KI-Bot besucht, und das ist Ihr Problem Nummer eins. Bei Cloudflare finden Sie dieselben Daten in der Auswertung des Bot-Traffics, ohne in Logs zu wühlen. Bei den in Österreich, Deutschland und der Schweiz verbreiteten Shared-Hosting-Paketen liegen die Zugriffslogs meist im Kundenbereich des Anbieters zum Download bereit.
Schritt 2: robots.txt
Öffnen Sie https://ihre-domain.at/robots.txt und prüfen Sie, ob einer der KI-Agenten ein Disallow hat. Prüfen Sie auch die Regel für User-agent: *, denn sie gilt für alle, die nicht einzeln aufgeführt sind.
Schritt 3: Live-Test in einem Modell
Gehen Sie zu ChatGPT oder Perplexity und bitten Sie um eine Zusammenfassung einer bestimmten Seite, mit Angabe der URL. Antwortet das Modell in Allgemeinplätzen oder gibt zu, die Seite nicht abrufen zu können, haben Sie ein Zugangsproblem. Fasst es den Inhalt korrekt zusammen, funktioniert die technische Ebene.
Das ist kein Test der Zitierfähigkeit, nur ein Test der Erreichbarkeit. Er prüft, ob das Modell Sie lesen kann, wenn Sie ihm die Adresse selbst in die Hand geben.
Schritt 4: Test der Zitierfähigkeit
Erst jetzt die eigentliche Frage: Nennt das Modell Sie von sich aus? Stellen Sie eine Kauffrage aus Ihrer Branche, ohne URL, zum Beispiel „Welches Unternehmen in Wien macht X?”, und sehen Sie nach, wer in der Antwort vorkommt.
Wiederholen Sie das in mehreren Modellen, denn die Ergebnisse können stark abweichen. Und wiederholen Sie es nach einem Monat, denn ein einzelner Messwert sagt nichts aus. Warum die Modelle so unterschiedlich entscheiden, erklären wir im Beitrag darüber, wie KI-Modelle ihre Quellen auswählen.
So schreiben Sie eine llms.txt
Das Format ist einfach und unter llmstxt.org beschrieben: reines Markdown, gespeichert als llms.txt im Stammverzeichnis.
Eine Struktur, die für eine Unternehmenswebsite funktioniert:
# Firmenname - was das Unternehmen macht

> Ein oder zwei Sätze: wer das ist, für wen gearbeitet wird, seit wann.

Warum wir eine glaubwürdige Quelle sind: Erfahrung, Zahlen, Zertifizierungen.


## Leistungen

- [Name der Leistung](https://domain.at/pfad/): ein Satz dazu, was es ist und für wen.

## Ratgeber

- [Titel](https://domain.at/pfad/): ein Satz dazu, welche Frage der Beitrag beantwortet.

## Kontakt

- [Kontakt](https://domain.at/kontakt/)
Drei Regeln, die den Unterschied machen:
- Vollständige URLs, keine relativen Pfade. Das Modell liest die Datei unter Umständen losgelöst von der Domain.
- Ein Satz Beschreibung zu jedem Link. Ein nackter Link sagt nichts.
- Nur das Wesentliche. Die Datei soll ein Inhaltsverzeichnis sein, keine Kopie der Sitemap. Dreißig gut gewählte Einträge sind mehr wert als dreihundert.
Für WordPress gibt es Plugins, die diese Datei automatisch erstellen. Prüfen Sie das Ergebnis trotzdem: Automatisch erzeugte Listen sind meist nur eine Kopie der Sitemap ohne Beschreibungen und verstoßen damit gegen Regel zwei und drei.
Und llms-full.txt?
Dabei handelt es sich um eine eigene Datei mit dem gesamten Inhalt der Website, zusammengeführt in einem einzigen Dokument, damit das Modell alles mit einer Anfrage abrufen kann. Sie ergibt Sinn für technische Dokumentation, bei der ein Programmier-Assistent sie tatsächlich benötigt. Für eine gewöhnliche Unternehmenswebsite ist sie schlicht Ballast.
Die häufigsten Fehler
KI-Bots aussperren und gleichzeitig eine llms.txt schreiben. Ein Widerspruch, der häufiger vorkommt, als man denkt – meist wegen Standardeinstellungen des CDN.
Die Sitemap hineinkopieren. Eine Liste von zweihundert URLs ohne Beschreibungen liefert dem Modell nichts, was es nicht ohnehin sehen würde.
Veraltete URLs. Die Datei wird einmal erstellt und dann vergessen – später führt die Hälfte der Links zu Weiterleitungen oder 404-Seiten.
Die Datei als Strategie behandeln. Eine llms.txt ist eine Stunde Arbeit am Ende der Liste, nicht an ihrem Anfang. Zuerst der Zugang für Bots, dann Inhalte, die sich zitieren lassen, danach die Präsenz in den Quellen, die die Modelle bereits zitieren. Diese Datei kommt zuletzt.
Zusammenfassung
Legen Sie eine llms.txt an, weil sie eine Stunde Aufwand kostet und die Beschreibung Ihres Angebots aufräumt. Erwarten Sie davon aber kein greifbares Ergebnis: Kein großes Modell hat bestätigt, sie zu lesen, und Google sagt offen, dass es sie nicht tut.
Die eigentliche Antwort auf die Frage „Sieht KI meine Website?“ liegt woanders: in der robots.txt, in den Server-Logs und darin, ob sich Ihre Absätze ohne Bearbeitung zitieren lassen. Diese drei Punkte prüfen Sie mit den oben beschriebenen Schritten in einer Stunde.
Wenn Sie möchten, dass jemand das gemeinsam mit Ihnen durchgeht und zeigt, wer in Ihrer Branche heute statt Ihres Unternehmens zitiert wird, sehen Sie sich an, wie wir als GEO-Agentur arbeiten, oder vereinbaren Sie ein kostenloses Beratungsgespräch. Wir betreuen Unternehmen in Österreich, Deutschland und der Schweiz auf Deutsch.